Ніва Элкін-Корэн — ізраільская даследчыца права, адна з вядучых спецыялістак па аўтарскім праве і кіраванні платформамі; калі пісала гэты артыкул, працавала ў Хайфскім універсітэце і ў Цэнтры Беркмана Кляйна па даследаванні інтэрнэту і грамадства пры Гарвардзе. Артыкул выйшаў летам 2020 года ў навуковым часопісе Big Data & Society, у тэматычнай падборцы «Паварот да ШІ» (The Turn to AI), — у першыя месяцы пандэміі COVID-19, калі Facebook, YouTube і іншыя платформы з-за каранціну адпусцілі людзей-мадэратараў дадому і перадалі праверку кантэнту ў асноўным машынам. Некалькі рэалій. «Бяспечная гавань» — прынцып, паводле якога платформа не адказвае за тое, што публікуюць карыстальнікі, калі хутка выдаляе незаконны кантэнт, як толькі пра яго паведамяць; у ЗША гэтую працэдуру «апавяшчэння і выдалення» ўвёў у 1998 годзе Закон аб аўтарскім праве ў лічбавае тысячагоддзе (DMCA). Content ID — сістэма YouTube, якая параўноўвае кожнае загружанае відэа з базай твораў праваўладальнікаў. Згаданая прапанова Еўрапейскай камісіі пра тэрарыстычны кантэнт у 2021 годзе стала рэгламентам ЕС з тым самым правілам адной гадзіны; а ў 2022 годзе ЕС прыняў Акт аб лічбавых паслугах, які абавязвае платформы тлумачыць карыстальнікам рашэнні аб выдаленні і дае ім права на абскарджанне, у тым ліку ў незалежных пазасудовых органах, — гэта збольшага адказ на тую самую праблему, хоць і не той «Грамадскі ШІ», які прапануе аўтарка. Twitter з 2023 года называецца X. Англійскае contesting algorithms можна прачытаць двойчы — і як «аспрэчванне алгарытмаў», і як «алгарытмы, што аспрэчваюць»; аўтарка мае на ўвазе абодва сэнсы, таму ў загалоўку мы пішам «Аспрэчваць алгарытмы», а саму ідэю — алгарытмы, якія аспрэчваюць рашэнні іншага алгарытму, — называем «аспрэчвальнымі алгарытмамі». Слова adversarial, якім аўтарка апісвае сваю мадэль, мы перакладаем як «спаборніцкі» — так, як у праве называюць спаборніцкі судовы працэс, дзе рашэнне нараджаецца ў спрэчцы двух бакоў. Мы пераклалі ўвесь асноўны тэкст артыкула. Анатацыю, ключавыя словы, спіс літаратуры, бібліяграфічныя спасылкі ў дужках і спасылкі на нарматыўныя акты мы прапусцілі; адзіную зноску ўключылі ў тэкст; схему спаборніцкага працэсу (мал. 1) прапусцілі — яе змест апісаны ў самім тэксце; там, дзе аўтарка пераказвае іншых даследчыкаў, у двух месцах назвалі іх па імёнах.
Уводзіны
Апошнімі гадамі анлайн-платформы ўкараняюць сістэмы машыннага навучання і штучнага інтэлекту (ШІ) — у гэтым артыкуле абодва паняцці ўжываюцца як узаемазаменныя, — каб не дапусціць загрузкі нібыта незаконнага кантэнту або выдаліць недазволеныя выказванні. Алгарытмы машыннага навучання вучаць распазнаваць непажаданы кантэнт і выдаляць яго, блакаваць або адфільтроўваць яшчэ да таго, як ён будзе загружаны. Калі пачалася пандэмія COVID-19, Facebook абвясціў, што адпраўляе дадому супрацоўнікаў, якія правяраюць кантэнт, і будзе больш «спадзявацца на праактыўнае выяўленне, каб выдаляць кантэнт, які парушае правілы». Гэты пераход да цалкам аўтаматызаванай мадэрацыі — не проста тэхнічная перамена. ШІ дае магутны інструмент мадэрацыі кантэнту, здольны працаваць у велізарных маштабах.
Сістэмы фільтрацыі на аснове ШІ надзеленыя цэнзарскай уладай, якая можа абыходзіць традыцыйныя стрымванні і процівагі, гарантаваныя правам. Алгарытмы машыннага навучання бяруць на сябе паўнамоцтвы прымаць рашэнні, якія звычайна належаць судам і адміністрацыйным органам. Алгарытмічнае прымяненне правілаў можа неапраўдана абмяжоўваць свабоду карыстальнікаў атрымліваць доступ да твораў — навуковых публікацый, культурных каштоўнасцей, навін, — знаёміцца з імі, перапрацоўваць іх і дзяліцца імі. Такі доступ неабходны для навучання і адукацыі, для развіцця інавацыйных рынкаў і для таго, каб грамадзяне былі дасведчанымі. Гэтыя інтарэсы абароненыя юрыдычнымі правамі, у тым ліку свабодай выказвання і «добрасумленным выкарыстаннем» (fair use). Непразрыстая і дынамічная прырода алгарытмаў машыннага навучання ўскладняе належную абарону гэтых правоў.
Больш за тое, сістэмы машыннага навучання не проста аўтаматызуюць прымяненне абмежаванняў на выказванні. Як будзе паказана далей, з пашырэннем мадэрацыі кантэнту з дапамогай ШІ змяняецца сама прырода рэгулявання выказванняў. Рэгуляванне выказванняў у шырокім сэнсе вызначае, што можна казаць, праз сацыяльныя і прававыя нормы. ШІ ўводзіць новы тып кіравання — заснаваны на дынамічных і адаптыўных працэсах прыняцця рашэнняў, якія кіруюцца данымі, карэляцыямі і прагнозамі. Кіраваць выказваннямі праз ШІ — значыць збіраць велізарныя масівы даных і ўжываць да іх метады аналітыкі, каб знаходзіць заканамернасці і карэляцыі і прадказваць тэндэнцыі і вынікі. За такімі прагнозамі ідзе аўтаматычная фільтрацыя або выдаленне выказванняў.
Рэгуляванне выказванняў з дапамогай ШІ прынцыпова адрозніваецца ад рэгулявання з дапамогай нормаў. Яно створанае, каб аптымізаваць адзін-адзіны кампраміс, вызначаны распрацоўшчыкам сістэмы. Таму яно часта не ўлічвае інтарэсаў усіх зацікаўленых бакоў і не абавязкова адлюстроўвае шырэйшыя грамадскія кампрамісы. Акрамя таго, непразрыстасць, дынамічнасць і адаптыўнасць інструментаў ШІ ствараюць сур’ёзныя перашкоды для грамадскага кантролю. Сёння ў нас няма адэкватных сродкаў, каб прыцягнуць гэтыя сістэмы да адказнасці. Увогуле, мадэрацыя кантэнту з дапамогай ШІ — праява росту некантраляванай прыватнай улады, якая можа выслізгваць ад традыцыйных стрымванняў і процівагаў, што павінны гарантаваць, каб улада ажыццяўлялася ў інтарэсах грамадства ў цэлым.
Каб запоўніць гэтыя прабелы, артыкул бярэ на ўзбраенне падыход «права праз праектаванне» (law by design). Я прапаную змякчыць праблемы, уласцівыя мадэрацыі кантэнту на аснове ШІ, праз спаборніцкі падыход, які называю «аспрэчвальнымі алгарытмамі» (contesting algorithms).
Ніжэй я апісваю стратэгію аспрэчвальных алгарытмаў і рэгулятыўныя меры, патрэбныя, каб яе ўкараніць. Спачатку я раскажу, як анлайн-платформы выкарыстоўваюць ШІ, каб прымяняць абмежаванні на выказванні. Потым — як пераход ад прававых нормаў да прымянення правілаў сіламі ШІ ўплывае на публічную сферу і якія выклікі ён стварае для асноўных дэмакратычных прынцыпаў. Нарэшце, я прадстаўлю стратэгію аспрэчвальных алгарытмаў і разгледжу наступствы спаборніцкага падыходу. Завяршаюць артыкул некалькі заўваг.
ШІ ў мадэрацыі кантэнту
За апошнія дзесяцігоддзі анлайн-платформы сталі фактычнымі арбітрамі выказванняў. Калі колькасць кантэнту, які ствараюць карыстальнікі, вырасла ў разы, першыя сістэмы праверкі людзьмі хутка і цалкам саступілі месца аўтаматызаваным механізмам кантролю за загружаным кантэнтам. У гэтым раздзеле я апісваю, як ШІ ў мадэрацыі кантэнту на платформах стаў пануючай парадыгмай кіравання выказваннямі ў публічнай сферы, і разглядаю, як прававы рэжым паўплываў на ўладкаванне гэтых сістэм.
Прыватнае прымяненне абмежаванняў на выказванні
Камунікацыя ў інтэрнэце ідзе праз жменьку глабальных платформаў — Facebook, Twitter, Google, — якія фактычна кіруюць доступам да кантэнту, да тых, хто выказваецца, і да патэнцыйнай аўдыторыі кожнага выказвання. Платформы, якія або размяшчаюць кантэнт (як Facebook), або даюць да яго доступ (як Google), могуць гэты доступ перакрыць, адфільтраваўшы, выдаліўшы ці заблакаваўшы непажаданыя выказванні. Таму платформы — натуральны пункт кантролю, дзе зручна сачыць за кантэнтам, фільтраваць яго, блакаваць і адключаць да яго доступ.
Гэтая функцыя брамніка зрабіла платформы ідэальным партнёрам для прымянення грамадзянскага і крымінальнага права. З канца 1990-х розныя законы заахвочвалі інтэрнэт-пасярэднікаў мадэраваць кантэнт у абмен на вызваленне ад адказнасці за тое, што публікуюць карыстальнікі (так званы рэжым «бяспечнай гавані»). Класічны прыклад — амерыканскі Закон аб аўтарскім праве ў лічбавае тысячагоддзе (DMCA), паводле якога платформы павінны неадкладна выдаляць матэрыялы, што нібыта парушаюць капірайт, як толькі атрымаюць апавяшчэнне ад праваўладальнікаў. Падобна і ў Еўрапейскім саюзе: паводле палажэнняў пра «бяспечную гавань» з Дырэктывы аб электроннай камерцыі 2000/31 хостынг-платформы не адказваюць за кантэнт, апублікаваны карыстальнікамі, калі яны яго не змянялі і не ведалі пра яго незаконны характар. Атрымаўшы апавяшчэнне, платформа абавязаная хутка выдаліць кантэнт.
Новыя еўрапейскія законы патрабуюць ад платформаў яшчэ хутчэйшай рэакцыі — значыць, платформы павінны актыўна мадэраваць кантэнт з самага пачатку. Напрыклад, нядаўна прыняты ў Германіі Закон аб забеспячэнні выканання права ў сацыяльных сетках (NetzDG) абавязвае пасярэднікаў выдаляць відавочна незаконны кантэнт на працягу 24 гадзін пасля скаргі. Паводле нядаўняй прапановы Еўрапейскай камісіі, пастаўшчыкі хостынгу павінны былі б выдаляць тэрарыстычны кантэнт або перакрываць да яго доступ на працягу адной гадзіны пасля таго, як атрымалі загад аб выдаленні. А нядаўна прыняты артыкул 17 Дырэктывы аб аўтарскім праве на адзіным лічбавым рынку прама патрабуе, каб хостынг-платформы загадзя забяспечвалі недаступнасць кантэнту карыстальнікаў, які парушае аўтарскае права, — інакш яны нясуць строгую адказнасць. Каб выконваць такія патрабаванні і рэагаваць так хутка, як патрабуе закон, платформы мусяць укараняць алгарытмічныя сродкі, якія адпавядаюць высокім галіновым стандартам прафесійнай стараннасці.
Мадэрацыя кантэнту з дапамогай ШІ
Аб’ём кантэнту, які ствараюць карыстальнікі, расце экспанентна, і разлічваць на праверку людзьмі стала немагчыма. Платформы распрацавалі аўтаматычныя фільтры кантэнту і хуткасныя сістэмы выдалення, каб эфектыўна выконваць свае абавязкі ў рамках «бяспечнай гавані». Пашырэнне адказнасці платформаў за патэнцыйна шкодны кантэнт іх карыстальнікаў яшчэ больш падштурхоўвае іх укараняць алгарытмы машыннага навучання. Гэтыя сістэмы аптымізаваныя пад хуткае выяўленне патэнцыйна шкоднага кантэнту. Тэхнічнае азначэнне «шкоднага» кантэнту можа мяняцца ў залежнасці ад прызначэння сістэмы: ці мусіць яна прымяняць дагаворныя стандарты платформы (напрыклад, азначэнне мовы нянавісці ў Стандартах супольнасці Facebook), ці забяспечваць выкананне патрабаванняў закона (напрыклад, забароны «распальвання нянавісці» паводле NetzDG).
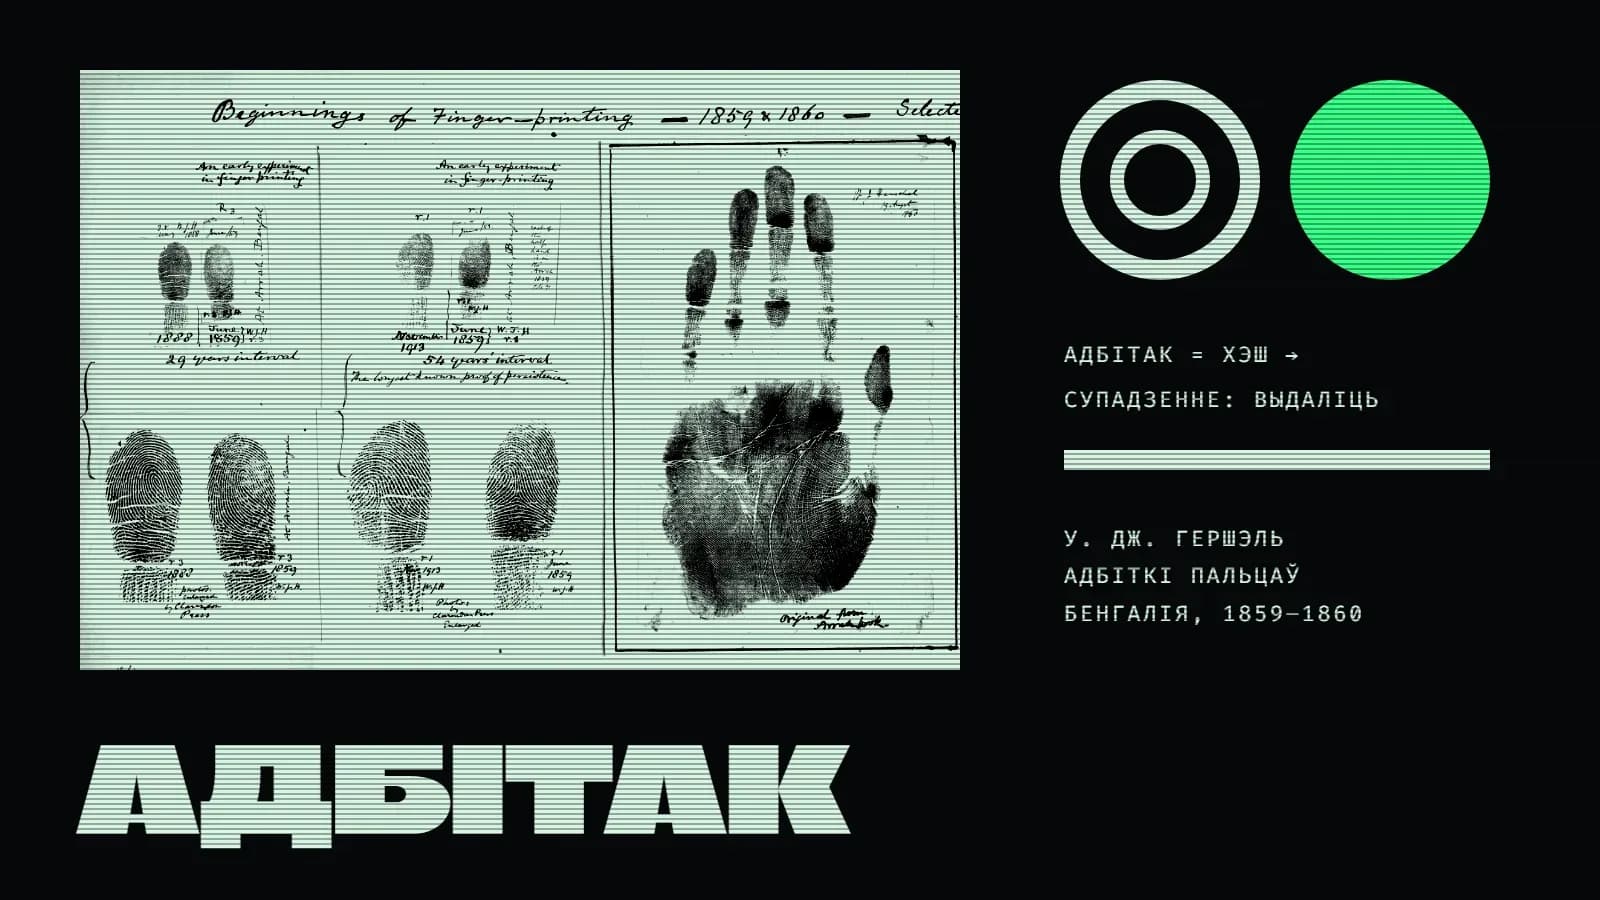
Інструменты машыннага навучання выкарыстоўваюцца ў самых розных кантэкстах. Адзін з іх — абарона інтэлектуальнай уласнасці. Так, Scribd, лічбавая бібліятэка электронных кніг і аўдыякніг па падпісцы, карыстаецца сістэмай BookID, якая стварае для кожнай кнігі лічбавы «адбітак» на аснове семантычных даных (колькасці слоў, частаты літар, супастаўлення фраз). Тэксты, загружаныя на Scribd, правярае BookID, і кантэнт, які супадае з якім-небудзь адбіткам, блакуецца. Гэтак жа Project Zero ад Amazon з дапамогай машыннага навучання бесперапынна праглядае абнаўленні картак тавараў і загадзя выдаляе меркаваныя падробкі — паводле лагатыпаў, гандлёвых марак і ключавых даных, якія даюць брэнды-партнёры.
Некаторыя платформы распрацавалі і добраахвотныя механізмы, якія выходзяць за межы іх юрыдычных абавязкаў у рамках «бяспечнай гавані» і адкрываюць новыя магчымасці для бізнесу. Класічны прыклад — Content ID на YouTube. З дапамогай лічбавага ідэнтыфікацыйнага кода Content ID выяўляе, што нядаўна загружанае відэа супадае з творам, які належыць праваўладальніку, і паведамляе яму пра гэта. Праваўладальнік можа заблакаваць або выдаліць кантэнт, атрымліваць пра яго звесткі ці манетызаваць яго.
Платформы выкарыстоўваюць машыннае навучанне і для таго, каб пазначаць і выдаляць іншыя віды шкодных выказванняў — мову нянавісці ці тэрарыстычную прапаганду. Напрыклад, Глабальны інтэрнэт-форум па процідзеянні тэрарызму — некамерцыйная арганізацыя, створаная самой галіной, — і Tech Against Terrorism, дзяржаўна-прыватнае партнёрства, запушчанае Выканаўчым дырэктаратам Контртэрарыстычнага камітэта ААН, змагаюцца з тэрарыстычнай прапагандай і экстрэмісцкім кантэнтам з дапамогай хэшаў. База хэшаў (унікальных лічбавых адбіткаў вярбовачных відэа тэрарыстаў ці выяў тэрарыстычнага гвалту) трымаецца ў сакрэце. Платформы-ўдзельніцы (сярод іх Facebook, Twitter і Microsoft) з дапамогай ШІ адфільтроўваюць тэрарыстычную прапаганду, выяўляючы выявы і відэа, якія супадаюць з гэтай прыватнай базай хэшаў.
Некаторыя сістэмы пабудаваныя на прагназаванні і прафілактыцы. Пры такім падыходзе алгарытмы машыннага навучання вучаць заўважаць непажаданы кантэнт раней, чым яго ўбачыць патэнцыйная аўдыторыя. YouTube, напрыклад, нядаўна абвясціў, што выяўляе экстрэмісцкі кантэнт з дапамогай ШІ. Паводле YouTube, больш за 83% відэа, выдаленых за справаздачны перыяд, пазначыў ШІ, і тры чвэрці з іх былі выдаленыя, перш чым іх хоць раз паглядзелі. З дапамогай машыннага навучання платформы могуць нават спрабаваць прадказаць і прадухіліць паводзіны, якіх ніколі не было і, магчыма, ніколі не будзе, — на аснове даных пра загружаны кантэнт і карыстальнікаў у рэальным часе. Прыклад — машыннае навучанне, якое сочыць за жывымі чатамі і метаданымі відэа, каб прадказваць трансляцыі спартыўных матчаў, што парушаюць капірайт. Каб не дапусціць жывых трансляцый шкоднага кантэнту — напрыклад, здымкаў забойства, тэракту ці самапашкоджання, — платформы павінны навучыцца прадказваць і хутка блакаваць іх распаўсюд, пакуль яны не разышліся па сетцы. Машыннае навучанне выкарыстоўваецца і для «выдалення назаўсёды» (takedown and stay down): платформа актыўна сочыць за загрузкамі, каб выдалены непажаданы кантэнт — ці любы падобны да яго — не з’явіўся зноў.
Увогуле, без сродкаў на аснове ШІ, магчыма, не абысціся, калі трэба кіраваць велізарнымі масівамі карыстальніцкага кантэнту аднастайна і ў той жа час з улікам асаблівасцей кожнага выпадку. Але выкарыстанне гэтых сістэм для кіравання выказваннямі выклікае і сур’ёзную занепакоенасць з пункту гледжання грамадскага дабрабыту. Пра гэта — у наступным раздзеле.
Алгарытмічная публічная сфера
Машыннае навучанне ўводзіць новы спосаб кіравання выказваннямі ў інтэрнэце. Цяпер, калі яно выкарыстоўваецца для мадэрацыі кантэнту паўсюдна, яно ставіць пад сумнеў прынцыпы, на якія традыцыйна абапіралася публічная сфера ў дэмакратычных грамадствах. Ніжэй я даводжу, што грамадскі кантроль над фільтрацыяй з дапамогай машыннага навучання неабходны, каб захаваць дэмакратычныя прынцыпы, і паказваю, чаму пераход да ШІ стварае новыя перашкоды для грамадскага нагляду.
Мадэрацыя кантэнту з дапамогай ШІ і грамадскі дабрабыт
Анлайн-дыскусія на лічбавых платформах і ёсць наша сучасная публічная сфера. Як трапна сказаў нядаўна суддзя Вярхоўнага суда ЗША Энтані Кенэдзі ў рашэнні па справе «Пэкінгем супраць Паўночнай Караліны» (2017):
«Калі ў мінулым, магчыма, і было цяжка вызначыць найважнейшыя месцы (у прасторавым сэнсе) для абмену поглядамі, то сёння адказ ясны. Гэта кіберпрастора — „неабсяжныя дэмакратычныя форумы інтэрнэту“ ўвогуле і сацыяльныя сеткі ў прыватнасці».
Як паказалі шматлікія даследчыкі, анлайн-платформы — зусім не нейтральная інфраструктура, якая проста злучае карыстальнікаў і дазваляе ім дзяліцца кантэнтам. Наадварот, гэтыя платформы фармуюць публічную сферу праз мікратаргетынг на аснове даных, калі кантэнт падладжваецца пад кожнага асобнага карыстальніка. Платформы ўвялі рэгуляванне выказванняў «новай школы», як назваў яго правазнаўца Джэк Балкін: яны спрыяюць адным выказванням, перашкаджаюць распаўсюду непажаданых і часам абмяжоўваюць пажаданыя. Дзякуючы свайму ўладкаванню платформы могуць дазваляць або забараняць загрузку кантэнту (праз фільтры загрузкі); вырашаць, які кантэнт застанецца даступным, а які будзе выдалены (напрыклад, праз выяўленне з дапамогай ШІ мовы нянавісці, тэрарыстычнай прапаганды ці парушэнняў капірайту); абмяжоўваць, хто можа ўдзельнічаць у анлайн-размовах (напрыклад, праз праверку асобы ці блакаванне акаўнтаў); вызначаць, як кантэнтам можна дзяліцца (напрыклад, праз «лайкі» ці рэтвіты), і хто, хутчэй за ўсё, яго ўбачыць (напрыклад, праз алгарытм рэкамендацый YouTube). Усе гэтыя магчымасці, што вызначаюць, як і што можна сказаць, падпарадкаваныя эканамічным інтарэсам прыватнага бізнесу. Але менавіта з іх складаецца лічбавая публічная сфера, і таму яны істотныя для агульнага дабра.
Тут я засяроджваюся на адной частцы мадэрацыі кантэнту платформамі — на той, дзе машыннае навучанне выкарыстоўваецца, каб фільтраваць і выдаляць непажаданы кантэнт. Ёсць некалькі прычын, чаму менавіта гэты бок мадэрацыі асабліва важны для агульнага дабра. Па-першае, грамадства зацікаўленае ведаць хоць нешта пра тое, якія выказванні былі адфільтраваныя з публічнай сферы. Дэмакратычны ідэал самакіравання народа мяркуе доступ да інфармацыі і права дасведчаных грамадзян свабодна абмяркоўваць справы, каб яны маглі разам вырашаць свой агульны лёс. Калі няма падсправаздачнасці, выдаленне выказванняў з публічнай сферы можа прымусіць замаўчаць некаторых з тых, хто выказваецца (напрыклад, грамадскіх актывістаў ці палітычных апанентаў), і пазбавіць грамадства доступу да легітымных выказванняў.
Можна запярэчыць, што публічная сфера фармуецца не толькі тым, чаго ў ёй няма, але і тым, што ў ёй ёсць. Значыць, грамадскі кантроль павінен тычыцца не толькі фільтраў загрузкі і аўтаматычнага выдалення выказванняў, але і любых выпадкаў, калі платформа не выдаліла шкодны кантэнт, здольны паўплываць на грамадскі дабрабыт. Аднак спрэчны кантэнт, апублікаваны ў інтэрнэце, можа стаць прадметам публічнай дыскусіі, тады як падставы для рашэнняў пра фільтрацыю і выдаленне не абавязкова бачныя. Ключавыя азначэнні таго, што лічыцца непажаданым кантэнтам (парушэнне капірайту, мова нянавісці, тэрарыстычная прапаганда), схаваныя ў кодзе машыннага навучання. Больш за тое, хоць рэжым «апавяшчэння і выдалення» дае працэдуру, каб аспрэчыць выдаленне кантэнту платформай, падобнага механізму, каб аспрэчыць масавую фільтрацыю выказванняў машынным навучаннем, сёння няма.
Яшчэ адна прычына засяродзіцца на выдаленні кантэнту ў тым, што фільтрацыя і выдаленне выказванняў часта адбываюцца ў адказ на юрыдычны абавязак або неафіцыйныя чаканні дзяржаўных органаў. Небяспека тут у тым, што ўлады будуць падштурхоўваць прыватны бізнес выконваць праваахоўныя задачы і так абыходзіць канстытуцыйныя абмежаванні, якія не дазваляюць дзяржаве ўжываць уладу, каб абмяжоўваць выказванні. Такое неапраўданае выдаленне кантэнту можа быць раўназначнае цэнзуры. Таму ў такіх выпадках ёсць моцны грамадскі інтарэс у тым, каб фільтрацыя адпавядала вяршэнству права і не абыходзіла канстытуцыйных гарантый свабоды слова.
Нарэшце, грамадскага нагляду за фільтрацыяй з дапамогай машыннага навучання патрабуе і рыначны падыход да мадэрацыі кантэнту. Пункт гледжання, паводле якога мадэрацыя кантэнту ў сацыяльных сетках — гэта «рынак ідэй» і таму платформы павінны мець свабоду мадэраваць без усякага дзяржаўнага нагляду, мяркуе, што карыстальнікі здольныя адрозніваць і выбіраць той тып мадэрацыі, які адпавядае іх перавагам (скажам, кансерватыўныя платформы ці ліберальныя, якія амаль нічога не выдаляюць). Але калі фільтрацыя з дапамогай машыннага навучання выдаляе выказванні непразрыста, яна не дае карыстальнікам дакладных сігналаў — і таму не спрыяе нармальнай рыначнай канкурэнцыі.
Увогуле, гэтыя меркаванні паказваюць, што ёсць моцны грамадскі інтарэс у тым, каб фільтры загрузкі і сістэмы выдалення, якія ўкараняюць прыватныя платформы, адпавядалі агульным інтарэсам грамадства. А там, дзе такія сістэмы выкарыстоўваюцца для прымянення закона, трэба гарантаваць, што яны адпавядаюць вяршэнству права.
Ёсць важкія прычыны сумнявацца, што фільтры на аснове ШІ сапраўды будуць адлюстроўваць грамадскі інтарэс. Па-першае, сённяшнія інструменты ШІ моцна залежаць ад кантэксту і яшчэ далёкія ад дакладных вынікаў. Напрыклад, некамерцыйная арганізацыя Counter Extremism Project сцвярджала, што Facebook не здолеў адсачыць і выдаліць добра вядомую ісламісцкую экстрэмісцкую прапаганду. У той жа час, паводле нядаўніх паведамленняў, сістэма машыннага навучання YouTube памылкова выдаліла больш за 100 000 праваабарончых відэа з Сірыі пра хімічныя атакі. Больш за тое, эксперты даводзяць, што ШІ не можа прымаць дакладныя рашэнні, абапіраючыся толькі на лінгвістычны аналіз кантэнту, бо сэнс любога выказвання залежыць ад кантэксту. Каб адрозніць парушальнае капіраванне ад забаўнай пародыі ці мову нянавісці ад законнага пратэсту, трэба разумець кантэкст. А ўлічваць кантэкст інструменты ШІ сёння ўмеюць горш за людзей-мадэратараў. Таму трэба пераконвацца, што мемы, допісы і відэа, якія выдаляюцца ці блакуюцца, сапраўды з’яўляюцца мовай нянавісці ці іншым незаконным кантэнтам, а не законным пратэстам супраць паліцэйскага гвалту ці жорсткіх дыктатур. Каб павысіць дакладнасць, некаторыя сістэмы абапіраюцца на ўскосныя прыкметы. Так, сістэмы, што пазначаюць тэрарыстычную прапаганду, улічваюць і геалакацыю, а для дакладных вынікаў патрабуюць праверкі людзьмі. Гэта ўздымае цэлы шэраг новых пытанняў — пра справядлівасць, падсправаздачнасць і магчымую прадузятасць такіх сістэм.
Іншая праблема — магчымы канфлікт інтарэсаў. Платформы выкарыстоўваюць ШІ, каб звязваць карыстальнікаў з кантэнтам. Іх бізнес-мадэль у тым, каб генераваць даныя пра карыстальнікаў і зарабляць на продажы іх профіляў для таргетаванай рэкламы ці іншых прадуктаў і паслуг на аснове даных. Падбор кантэнту для карыстальнікаў павінен павялічыць колькасць даных пра кожнага, пашырыць іх віды і зрабіць іх як мага свяжэйшымі. Таму платформы імкнуцца захоўваць кантэнт, які можа падвысіць уцягнутасць у сацыяльных сетках, і выдаляць толькі той, што гэтай мэце можа перашкодзіць. А з пункту гледжання грамадства выдаленне кантэнту можа патрабаваць узважвання шырокага кола інтарэсаў — прыватнасці, асабістай бяспекі, нацыянальнай бяспекі, а таксама свабоды слова, права на пратэст і доступу да культуры і ведаў.
Як ШІ змяняе кіраванне выказваннямі
Выкарыстанне машыннага навучання, каб выяўляць і выдаляць непажаданыя выказванні, змяняе тое, як мы кіруем публічнай сферай: ад кіравання праз нормы — да кіравання праз ШІ.
Прававыя нормы фармуюць выказванні праз яўныя правілы і прынцыпы. Публічнае права вызначае межы свабоды слова: дае азначэнне таго, што такое выказванне, і забяспечвае выкананне нормаў пра выказванні. Дагаворныя ўмовы карыстання, такія як Стандарты супольнасці Facebook, таксама даюць азначэнні дапушчальных выказванняў. Вяршэнства права азначае, што людзьмі кіруюць правілы — празрысты набор нормаў, які адлюстроўвае грамадскую дамову, аднолькава прымяняецца да ўсіх членаў грамадства і ажыццяўляецца праз грамадскія інстытуты. Заканадаўцы ствараюць законы, каб павялічыць грамадскі дабрабыт, знаходзячы прымальны баланс паміж супярэчлівымі мэтамі і інтарэсамі. Абмежаванні на выказванні, вызначаныя законам, таксама задаюцца яўнымі нормамі, якія адлюстроўваюць наш грамадскі выбар. Законы прымяняюцца праз бесстароннія судовыя рашэнні: суды прыкладаюць агульныя нормы да канкрэтных выпадкаў і такім чынам вырашаюць, як дасягнуць аптымальнага балансу паміж супярэчлівымі інтарэсамі.
ШІ, наадварот, уводзіць новы тып кіравання. Фільтры на машынным навучанні ўвасабляюць дынамічныя і адаптыўныя працэсы прыняцця рашэнняў, якія кіруюцца данымі. Такое кіраванне патрабуе збіраць велізарныя масівы даных. Да гэтых сховішчаў ужываюць метады аналітыкі, каб знайсці заканамернасці і карэляцыі, з дапамогай якіх можна прадказваць тэндэнцыі і вынікі, а потым выконваць аўтаматычнае дзеянне (фільтраваць, выдаляць, блакаваць).
Мадэрацыя кантэнту можа абапірацца на навучанне з настаўнікам: алгарытм вучаць на загадзя размечаных даных, каб ён адрозніваў забароненыя выказванні ад дапушчальных. Напрыклад, каб навучыць сістэму адсейваць тэрарыстычную прапаганду, у навучальных даных павінны быць выявы з пазнакай «прапаганда „Ісламскай дзяржавы“» і падобнымі, а побач — выявы з пазнакай «дапушчальна». Калі навучальных даных дастаткова, сістэма павінна навучыцца адрозніваць тэрарыстычную прапаганду ад усяго астатняга. Сістэмы на аснове лічбавых хэшаў могуць навучыцца пазнаваць і кантэнт, падобны да размечанай выявы, нават калі ён ёй не ідэнтычны. Мадэрацыя з дапамогай ШІ можа грунтавацца і на глыбокім навучанні, дзе нейронныя сеткі дазваляюць сістэмам распазнаваць прыкметы ў складаных уваходных даных.
Кіраванне кантэнтам праз ШІ адрозніваецца ад кіравання выказваннямі праз нормы ў некалькіх важных адносінах. Па-першае, кіраванне выказваннямі праз ШІ залежыць ад велізарных аб’ёмаў даных і пастаяннага сачэння, а гэта можа пагражаць прыватнасці. Як паказала Шошана Зубаф, логіка вялікіх даных грунтуецца не толькі на масавым сачэнні, але і на бескампрамісным патрабаванні поўнай празрыстасці ад карыстальнікаў — без узаемнай празрыстасці з боку тых, хто даныя апрацоўвае і валодае імі. Таму выкарыстанне ШІ для кіравання выказваннямі ў інтэрнэце можа закранаць таксама роўнасць і чалавечую годнасць і не дае дастатковых гарантый належнай прававой працэдуры. Гэтыя пытанні я пакіну на іншы раз.
Па-другое, сістэмы машыннага навучання змешваюць камерцыйныя інтарэсы платформаў з дзяржаўнымі функцыямі, якія тыя выконваюць. Розныя функцыі платформаў у мадэрацыі кантэнту — камерцыйныя (прыватныя) і праваахоўныя (публічныя) — убудаваныя ў адну і тую ж сістэму машыннага навучання, карыстаюцца тымі самымі данымі і кіруюцца тымі самымі прыкметамі.
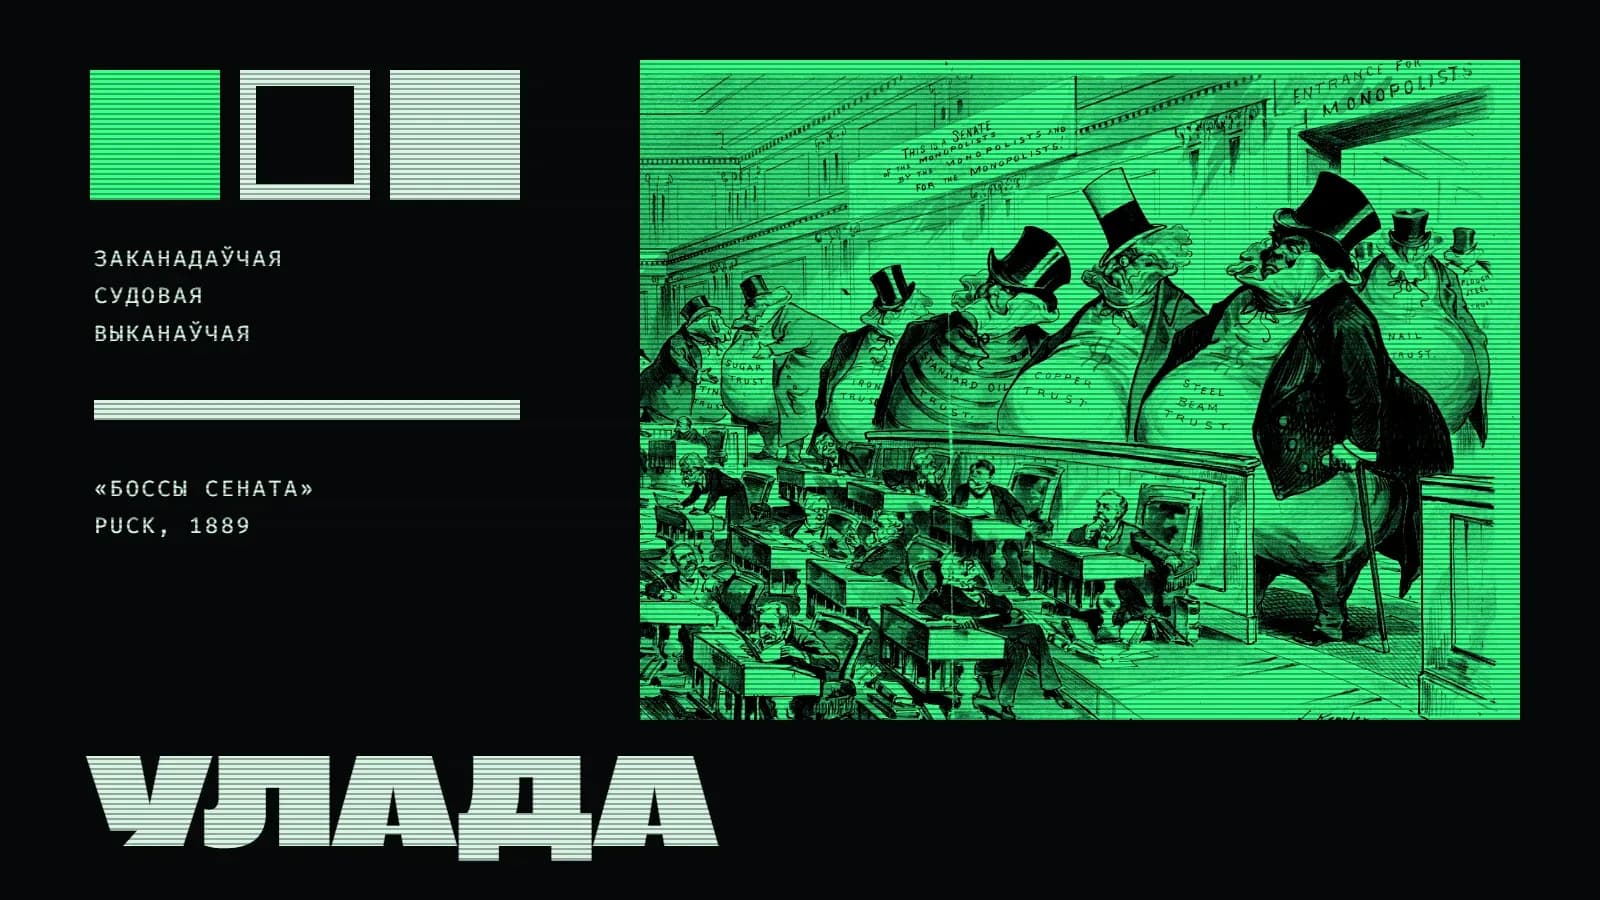
Возьмем, напрыклад, абарону аўтарскага права. Закон пра аўтарскае права вызначае, што такое яго парушэнне, і дае ўладальніку права абараняць яго ў судзе. Калі Content ID на YouTube аўтаматычна пазначае матэрыялы, якія нібыта парушаюць капірайт, ён фактычна вырашае, які кантэнт з’яўляецца парушэннем (судовая ўлада), і сам жа выдаляе, адключае ці фільтруе гэты кантэнт (выканаўчая ўлада). Больш за тое, Content ID фактычна вызначае і межы аховы аўтарскага права, бо вырашае, наколькі падобнымі павінны быць арыгінал і меркаваная копія, каб спрацавала выдаленне (заканадаўчая ўлада). Пры гэтым сістэма дае праваўладальнікам магчымасць манетызаваць кантэнт, дзелячыся прыбыткам з YouTube. Гэта можа ствараць сістэмны канфлікт інтарэсаў, закладзены ў саму канструкцыю. Алгарытмы машыннага навучання ствараюцца, каб максімізаваць прыбытак тых, хто іх укараняе, і таму, хутчэй за ўсё, маюць камерцыйную прадузятасць, нябачную звонку. Платформы, вядома, маюць права прасоўваць свае законныя камерцыйныя інтарэсы. Але калі платформы выконваюць публічныя функцыі (напрыклад, фільтруюць кантэнт, каб прымяняць закон) або іншым чынам рэгулююць выказванні так, што гэта закранае агульнае дабро, іх прыватныя інтарэсы і публічныя функцыі становяцца непадзельнымі. Алгарытм машыннага навучання, які выкарыстоўваецца для (публічнага) прымянення закона, будзе абапірацца на тую ж разметку карыстальнікаў і кантэнту — і на той самы праграмны інтэрфейс (API), тыя самыя навучальныя заканамернасці і праграмы падбору кантэнту для карыстальнікаў, — што служаць камерцыйным мэтам.
Нарэшце, ШІ хавае тое, як мы вызначаем нормы выказвання і грамадскія кампрамісы. Прававыя нормы яўна абвяшчаюцца загадзя (ex ante), калі ствараюцца стымулы (або антыстымулы) для іх выканання. Стымулы і санкцыі прывязваюцца да паводзін. Яны могуць прымяняцца і пастфактум (ex post), але іх мэта — заахвоціць рацыянальных удзельнікаў выконваць нормы і адпаведна будаваць свае паводзіны. Гэтыя нормы (пра парушэнне капірайту, паклёп, падбухторванне) адлюстроўваюць пэўныя грамадскія кампрамісы (напрыклад, паміж стымуламі для аўтараў і добрасумленным выкарыстаннем).
Сістэмы машыннага навучання ўводзяць іншы тып кіравання. Яны не проста прымяняюць нормы, але і ствараюць новыя. Мадэрацыю кантэнту з дапамогай ШІ могуць распрацаваць дзеля яўнай мэты (напрыклад, выяўляць мову нянавісці), але яна можа мець і рэгулятыўны эфект: фармаваць паводзіны карыстальнікаў, аддзяляючы дапушчальныя выказванні ад недапушчальных (выдаляюцца толькі апошнія). У адрозненне ад прававых нормаў, якія ўтрымліваюць яўныя азначэнні незаконнага кантэнту (напрыклад, матэрыялаў, што парушаюць капірайт, ці заклікаў да гвалту), алгарытмы машыннага навучання створаныя знаходзіць заканамернасці і рабіць прагнозы, не раскрываючы, якія нормы яны прымяняюць. Яны проста выяўляюць, класіфікуюць і прадказваюць тэндэнцыі і вынікі, за чым часта ідуць аўтаматычныя дзеянні (фільтраванне, выдаленне ці блакаванне кантэнту). Ці будзе той ці іншы кантэнт класіфікаваны як дапушчальны ці незаконны, часта залежыць ад загадзя зададзеных прыкмет і іх вагаў, а таксама ад канкрэтнага набору навучальных даных; і з часам на гэта, хутчэй за ўсё, будзе ўплываць новае навучанне.
Мадэрацыя кантэнту на аснове машыннага навучання — імавернасная. Рашэнні забараніць ці выдаліць кантэнт могуць залежаць ад мноства зменлівых фактараў: ці перавысіў кантэнт вылічальны парог; ці спрацоўвала сістэма раней на падобны кантэнт; ці пазначалі гэты ці падобны кантэнт трэція асобы; і як часта ўсё гэта адбывалася. Такая ўласцівасць мадэрацыі на машынным навучанні падрывае важны прынцып вяршэнства права, які мяркуе самакіраванне аўтаномных асоб, здольных кіравацца нормамі ў сваіх паводзінах.
Больш за тое, у сістэмах машыннага навучання няма ні яўнага азначэння кампрамісаў, якія яны фактычна прымяняюць, ні працэдур, каб гэтыя кампрамісы вызначаць, абмяркоўваць і ўзгадняць супярэчлівыя інтарэсы. Гэтыя сістэмы настроеныя аптымізаваць пэўную функцыю — напрыклад, выдаляць матэрыялы, якія парушаюць капірайт так, як яго разумеюць праваўладальнікі, ці выдаляць тэрарыстычны кантэнт паводле вядомых хэшаў. Тэхнічнае азначэнне такіх мэтаў непазбежна адлюстроўвае пэўныя каштоўнасныя кампрамісы: адны прыкметы выключаюцца, а сістэму падкручваюць, каб яна аддавала перавагу аднаму выніку перад іншым. Тэхнічныя азначэнні пэўных прыкмет і іх вагі фактычна вызначаюць, ці будзе канкрэтная выява, тэкст ці відэа класіфікаваныя як недапушчальнае выказванне, якое трэба выдаліць. Такім чынам, нормы ўсталёўваюцца праз дынамічнае агрэгаванне і аналіз папярэдніх выпадкаў і заканамернасцей, а сам вынік можа быць невытлумачальным.
Мадэрацыя кантэнту заўсёды ўключае кампрамісы, выбар каштоўнасцей і расстаноўку прыярытэтаў. Што лічыцца незаконным кантэнтам і хто мае права гэта вырашаць — палітычны выбар. Прававыя нормы складаюцца з яўных кампрамісаў, якія абмяжоўваюць свабоду слова, каб абараніць прыватныя інтарэсы (напрыклад, асабістую рэпутацыю, якую ахоўвае закон пра паклёп), асноўныя правы (напрыклад, законы, што забараняюць мову нянавісці) ці нацыянальную бяспеку (напрыклад, законы пра шпіянаж, якія ахоўваюць сакрэтныя матэрыялы). Законы розных краін і праўда часта па-рознаму ўзважваюць свабоду слова і гэтыя іншыя інтарэсы. Але, пераходзячы да кіравання выказваннямі праз машыннае навучанне, мы губляем важную магчымасць даследаваць нормы і разам, усім грамадствам, узгадняць каштоўнасныя кампрамісы, закладзеныя ў іх.
Увогуле, сістэмы выдалення на аснове ШІ створаныя, каб аптымізаваць пэўныя мэты, якія фармуюцца камерцыйнымі інтарэсамі платформаў. Кампрамісы, закладзеныя ў гэтыя сістэмы, могуць ігнараваць некаторыя каштоўнасці, важныя для грамадскага інтарэсу (добрасумленнае выкарыстанне, свабоду слова). Інстытуцыйны пераход рэгулятыўнай улады ад дзяржавы да прыватных кампаній дазваляе вырашаць ключавыя кампрамісы гульцам рынку — незалежна ад іх камерцыйнай прадузятасці. Сёння ў нас няма дастатковых сродкаў, каб высветліць, што гэта за кампрамісы, і пераканацца, што гэтыя сістэмы сапраўды адлюстроўваюць нашу грамадскую дамову.
Нагляд і яго межы
Мадэрацыя кантэнту з дапамогай машыннага навучання можа ўплываць на грамадскі дабрабыт, і пры гэтым у ёй няма адпаведных стрымванняў улады і надзейных засцярог ад злоўжыванняў. Даследаванні таго, як платформы алгарытмічна рэалізуюць рэжым «апавяшчэння і выдалення», паказваюць, наколькі такія сістэмы ўразлівыя для злоўжыванняў, калі за імі няма належнага нагляду. Напрыклад, высветлілася, што трэція асобы масава выкарыстоўвалі гэтыя сістэмы, каб выдаляць матэрыялы, якія нічога не парушалі і мала мелі дачынення да капірайту. Гэтыя высновы падкрэсліваюць, наколькі непразрыстыя аўтаматызаваныя сістэмы прымянення правілаў уразлівыя для махлярства і злоўжыванняў.
Тут я засяроджваюся на іншай праблеме: як дамагчыся, каб сістэмы выдалення на аснове ШІ адлюстроўвалі нашу грамадскую дамову.
ШІ хутка развіваецца, а з ім расце і яго рэгулятыўная сіла — здольнасць фармаваць паводзіны. Таму ўсё шырэй разумеюць, што грамадства трэба трымаць «у контуры» рашэнняў. У літаратуры пра кіраванне з дапамогай ШІ прапаноўваюцца меры празрыстасці і нагляду, каб павысіць падсправаздачнасць сістэм машыннага навучання. Сярод прапаноў рэформаў — патрабаваць большай празрыстасці, калі ШІ выкарыстоўвае дзяржава, ці пашырыць следчыя паўнамоцтвы дзяржаўных органаў (як у законапраекце аб алгарытмічнай падсправаздачнасці, унесеным у Кангрэс ЗША ў 2019 годзе).
Гэта важныя меры, але ў іх ёсць сур’ёзныя абмежаванні. Алгарытмы машыннага навучання непразрыстыя. Нават калі мэты і метрыкі сістэмы яўна абвешчаныя, шмат што залежыць ад таго, як гэтыя агульныя каштоўнасці ўвасобленыя ў кодзе. Нормы (прыкметы, вагі) можна зрабіць яўнымі, але праз дынамічнасць сістэм машыннага навучання такая празрыстасць мала што дае. Вынікі ў значнай ступені вызначаюцца навучальнымі данымі, а таксама данымі, якія збіраюцца ў рэальным часе, пакуль сістэма працуе і атрымлівае зваротную сувязь. Часам, як у выпадку нейронных сетак, працэс выдабывання заканамернасцей з даных — а значыць, і сувязь паміж уваходнымі данымі і вынікамі — непразрысты і невытлумачальны нават для даследчыкаў даных, адказных за сістэму. Справаздачы аб празрыстасці і грамадскі нагляд, як правіла, аказваюцца бяссільнымі, калі трэба гарантаваць, што гэтыя алгарытмічныя рэжымы служаць грамадскаму дабрабыту.
Больш за тое, алгарытмы і даныя часта абароненыя як камерцыйная таямніца і недаступныя шырокай публіцы — у тым ліку даныя пра тое, наколькі ўдалымі былі мінулыя прагнозы алгарытму: іх збіраюць і выкарыстоўваюць, каб навучыць алгарытм рабіць больш дакладныя прагнозы ў будучыні. Таму немагчыма зразумець, чаму адзін кантэнт прызнаецца дапушчальным, а іншы падлягае выдаленню. Па той жа прычыне цяжка выявіць прадузятасць супраць пэўных выказванняў ці тых, хто выказваецца, а значыць, і стварыць інструменты, каб з ёй змагацца. Калі ж сістэмы ствараюцца, каб блакаваць выказванні яшчэ да публікацыі, адсачыць тое, чаго не стала, яшчэ цяжэй — і для грамадскага нагляду ўзнікаюць новыя перашкоды.
Іншы спосаб пашырыць нагляд — працэдурны: увесці права абскардзіць неапраўданае рашэнне аб выдаленні. Аднак даследаванні паказалі, што нават там, дзе права на абскарджанне ёсць (як працэдура сустрэчнага апавяшчэння паводле DMCA), на практыцы ім карыстаюцца рэдка і ўвогуле яно не стала дзейсным сродкам абароны.
Непразрыстасць кампрамісаў, якія ўжываюць алгарытмы, ускладняе прымяненне да іх звычайных сродкаў грамадскага і прававога нагляду. Цяжка таксама прыдумаць прававыя механізмы кантролю над дынамічнымі алгарытмамі, якія вучацца і ўвесь час змяняюцца, — ды яшчэ ў шырокай тэхналагічнай экасістэме, дзе бесперапынная распрацоўка — норма. Таму алгарытмічнае кіраванне можа патрабаваць новых відаў пастаяннага прававога ўмяшання, якія дазволяць увесь час узгадняць каштоўнасці і падтрымліваць грамадскі кантроль.
Аспрэчвальныя алгарытмы
Увогуле, мадэрацыя кантэнту з дапамогай ШІ можа ўплываць на грамадскі дабрабыт, а дастатковага механізму, які гарантаваў бы, што такія сістэмы адлюстроўваюць нашу грамадскую дамову і адпавядаюць вяршэнству права, няма. Шэраг даследчыкаў прапаноўвалі выправіць гэтую праблему знутры — праз мадэль удзелу, якая ўключае розныя зацікаўленыя бакі або ў праектаванне сістэм, або ў маніторынг таго, ці адпавядаюць яны грамадскім каштоўнасцям. Некаторыя прапановы імкнуцца паўплываць на вынікі мадэрацыі, прыцягваючы платформы да адказнасці за шкодны кантэнт. Агульнае ў гэтых прапановах — спроба паўплываць на канфігурацыю пануючай сістэмы мадэрацыі. Я ж прапаную іншы падыход: пастаянна правяраць тое, як выкарыстоўваюцца сістэмы выдалення на аснове ШІ, уводзячы ў іх трэнне. Галоўную праблему цяперашняга рэжыму алгарытмічнай мадэрацыі кантэнту я бачу ў тым, што ў ім няма ніякага спаборніцкага ціску. Сістэма настроеная аптымізаваць адзін вынік, які адлюстроўвае загадзя вызначаны кампраміс, — і ў ёй няма месца для абмеркавання, перамоў і аспрэчвання, без якіх немагчыма кіраваць выказваннямі ў ліберальных дэмакратыях. Мэта аспрэчвальных алгарытмаў — запоўніць гэты прабел. Ідэя ў тым, каб перад выдаленнем уставіць аўтаматычны кантрольны пункт, які адлюстроўвае разнастайныя грамадскія каштоўнасці, і такім чынам стварыць процівагу маналітным сістэмам выдалення кантэнту на платформах.
Ніжэй я апісваю мадэль аспрэчвальных алгарытмаў, яе асноўныя прынцыпы і перавагі.
Спаборніцкі «Грамадскі ШІ»
Спаборніцкая публічная сістэма — назавём яе «Грамадскі ШІ» (Public AI) — будзе створаная, каб незалежна адлюстроўваць грамадскія каштоўнасці, недастаткова прадстаўленыя ў пануючай сістэме выдалення на платформе. Платформы будуць абавязаныя праганяць кожнае рашэнне аб выдаленні праз Грамадскі ШІ, перш чым нешта выдаліць. Так яны будуць даваць карысныя даныя пра тое, які кантэнт выдаляецца, а заадно правяраць, ці не разыходзіцца рашэнне з грамадскімі каштоўнасцямі. Калі Грамадскі ШІ пацвердзіць рашэнне, выдаленне адбудзецца. Калі ж узнікне спрэчка — ацэнка платформы схіляецца да «выдаліць», а ацэнка Грамадскага ШІ да «пакінуць», — выдаленне адкладаецца, пакуль канфлікт не будзе вырашаны. Каб вырашыць, чыя ацэнка пераважыць, можна ўжыць правілы анлайн-урэгулявання спрэчак або перадаць спрэчку на разгляд людзям. Калі належны баланс паміж супярэчлівымі ацэнкамі знойдзены, алгарытм Грамадскага ШІ абнаўляецца з улікам гэтых рашэнняў. У паўторных выпадках будзе прымяняцца ўжо вылічальнае азначэнне такога балансу.
Сэнс аспрэчвальных алгарытмаў у тым, каб ураўнаважыць адзіны стандарт аптымізацыі цяперашніх сістэм выдалення кантэнту, увёўшы спаборніцкую мадэль. Ёсць падрыўныя стратэгіі, якія прапануюць выкарыстоўваць спаборніцкі код ці даныя, каб перанастроіць пануючыя сістэмы машыннага навучання (напрыклад, «тэхналогіі ахоўнай аптымізацыі», Protective Optimization Technologies). У адрозненне ад іх, спаборніцкая мадэль, прапанаваная тут, мае на мэце стварыць процівагу. Падрыўныя інструменты могуць спрыяць сацыяльнаму пратэсту і служыць важным палітычным мэтам, але наўрад ці зменяць вынік для грамадства: платформы, хутчэй за ўсё, прымуць меры, каб ім процідзейнічаць, і пачнецца тэхналагічная гонка ўзбраенняў.
Спаборніцкая стратэгія імкнецца вярнуць у мадэрацыю кантэнту грамадскі інтарэс. Возьмем, напрыклад, выдаленне матэрыялаў, якія нібыта парушаюць аўтарскае права. Закон пра аўтарскае права вызначае пэўны набор кампрамісаў. Ён імкнецца заахвоціць стварэнне новых твораў, гарантуючы стымулы для аўтараў, і ў той жа час захаваць свабоду цяперашніх і будучых аўтараў выкарыстоўваць існыя творы. Абмежаванні і выключэнні з аўтарскага права — такія як добрасумленнае выкарыстанне ў амерыканскім праве ці «цытаванне, крытыка, агляд» і «карыкатура, пародыя ці пастыш» у еўрапейскім — стрымліваюць капірайт, каб ён не душыў тую самую творчасць, якую закон хоча заахвоціць. Гэтыя абмежаванні могуць абараняць і іншыя грамадскія каштоўнасці, напрыклад свабоду выказвання. Калі мадэрацыя кантэнту кіруецца правіламі, гэтыя супярэчлівыя каштоўнасці сутыкаюцца ў судах, і кампрамісы вызначаюцца праз судовы разгляд. Сістэма выдалення на машынным навучанні, наадварот, хутчэй за ўсё ўвасобіць маналітны кампраміс. Уявім, напрыклад, мем на Facebook, які складаецца з выявы, абароненай капірайтам (скажам, дыснэеўскага персанажа), і арыгінальнага тэксту (скажам, жартаўлівай крытыкі ўлады карпарацый). У такім меме інтарэс праваўладальніка (Disney) — не дапусціць несанкцыянаванага выкарыстання свайго твора — сутыкаецца з інтарэсам аўтара мема ў свабодзе выказвання. Калі сістэма аўтаматычна выдаляе мем, знайшоўшы супадзенне з абароненай выявай Disney, яна прымяняе пэўны кампраміс — той, што дае перавагу правам уладальнікаў капірайту.
У прапанаванай сістэме, калі алгарытм машыннага навучання платформы класіфікаваў кантэнт як парушальны, але яшчэ нічога з ім не зрабіў (напрыклад, не выдаліў), платформа будзе абавязаная праверыць гэтую класіфікацыю, прапусціўшы кантэнт праз Грамадскі ШІ. Грамадскі ШІ будзе створаны, каб адлюстроўваць каштоўнасці, замацаваныя ў аўтарскім праве, у тым ліку добрасумленнае выкарыстанне і свабоду выказвання. У яго будзе закладзенае колькаснае азначэнне законнага выкарыстання, якое адлюстроўвае сукупныя меркаванні зацікаўленых бакоў — усіх, каго сістэма можа закрануць, нават калі іх інтарэсы цяпер не ўлічаныя ў сістэме выдалення платформы («грамадскія інтарэсы»). У выпадку з капірайтам гэтымі зацікаўленымі бакамі могуць быць законныя карыстальнікі кантэнту, якіх прызнае цяперашняя сістэма аўтарскага права: студэнты, якія вучацца самастойна; настаўнікі, што выкарыстоўваюць творы ў навучанні; бібліятэкары; дакументалісты; карыстальнікі, якія робяць рэміксы не дзеля прыбытку. Асновай для праектавання мадэлі і навучальных даных могуць стаць рашэнні судоў па справах пра законнае выкарыстанне кантэнту («добрасумленнае выкарыстанне»). Мадэлі могуць выкарыстоўваць і параметры, выяўленыя юрыстамі-даследчыкамі, якія вывучалі розныя фактары ў судовых рашэннях, каб прадказваць, калі выкарыстанне будзе прызнанае добрасумленным. Акрамя таго, мадэль можа абапірацца на даныя назіранняў — напрыклад, на аналіз таго, як рэальна выкарыстоўваюць абароненыя матэрыялы асноўныя зацікаўленыя бакі: бібліятэкары, педагогі, журналісты, удзельнікі рэміксавых супольнасцей.
Карацей, алгарытм Грамадскага ШІ будзе правяраць, ці не супярэчаць рашэнні аб выдаленні іншым грамадскім інтарэсам — такім як добрасумленнае выкарыстанне ці свабода слова. Калі такіх супярэчнасцей няма, кантэнт выдаляецца. Калі ж ёсць канфлікт, працэдура ўрэгулявання спрэчкі супаставіць ацэнкі абедзвюх сістэм, каб вызначыць імавернасць парушэння ці добрасумленнага выкарыстання. Сістэма можа ўключаць і яўныя (колькасныя) правілы, якія вызначаюць, чыя ацэнка пераважвае і калі спрэчку трэба перадаць на разгляд людзям.
Як укараніць такую спаборніцкую мадэль? Адносна просты крок — змяніць цяперашні рэжым «бяспечнай гавані». Закон можа дазваляць платформе карыстацца «бяспечнай гаванню» толькі пры ўмове, што кожную сваю ацэнку яна правярае на Грамадскім ШІ, перш чым выдаліць кантэнт. Рэгулятары могуць вызначаць і кола грамадскіх інтарэсаў, якія павінны ўлічваць аспрэчвальныя алгарытмы, — указваць, якія зацікаўленыя бакі павінны быць прадстаўленыя і якую вагу трэба надаваць таму ці іншаму інтарэсу.
Перавагі спаборніцкай стратэгіі
Спаборніцкасць — асноватворны прынцып і ў інфарматыцы, і ў судовым працэсе. У інфарматыцы спаборніцкія стратэгіі выкарыстоўваюць, каб шукаць слабыя месцы алгарытмаў машыннага навучання — «чорных скрынь». Спаборніцкія алгарытмы навучання дазваляюць пастаянна сачыць за непразрыстымі алгарытмамі машыннага навучання. Напрыклад, генератыўна-спаборніцкія сеткі (GAN) з дапамогай навучання без настаўніка аўтаматычна выяўляюць, чаму навучылася асноўная сістэма машыннага навучання і якія заканамернасці ў ёй склаліся.
Гэтак жа спаборніцкасць неабходная для вяршэнства права. Спаборніцкі працэс, у якім бакі выкладаюць свае супрацьлеглыя пазіцыі перад суддзём ці прысяжнымі, — адна з асноў судовых сістэм агульнага права і «залаты стандарт» вырашэння спрэчак. Лічыцца, што спаборніцкі працэс лепш дазваляе праверыць доказы, устанавіць ісціну і прыняць абгрунтаванае рашэнне. Таму ён служыць працэдурным стрымваннем дзяржаўнай улады ў крымінальных справах ці пры абскарджанні злоўжыванняў адміністрацыйнай уладай.
У мадэрацыі кантэнту з дапамогай машыннага навучання падобных спаборніцкіх механізмаў сёння няма. Таму сістэма, створаная аптымізаваць адну мэту (напрыклад, выдаляць любыя матэрыялы, якія супадаюць з узорамі, прадстаўленымі праваўладальнікамі), можа не ўлічыць шырокага кола грамадскіх інтарэсаў, якія гэты выбар закранае (адукацыю, добрасумленнае выкарыстанне, палітычную пародыю). Мая прапанова імкнецца запоўніць гэты прабел, зрабіўшы спаборніцкую працэдуру абавязковай.
Спаборніцкі падыход, які кідае выклік маналітнай сістэме мадэрацыі кантэнту на платформах, мае некалькі пераваг. Сярод іх — падтрымка плюралізму, пастаянны дынамічны нагляд, вяртанне грамадскага інтарэсу, а таксама спрыянне канкурэнцыі і інавацыям.
Падтрымка плюралізму
Мадэрацыя кантэнту патрабуе кампрамісаў паміж супярэчлівымі каштоўнасцямі і інтарэсамі розных зацікаўленых бакоў. Калі б мы загадзя ведалі, якія каштоўнасці трэба ўлічваць у кожнай спрэчцы пра кантэнт і якія кампрамісы прымяняць, мы маглі б зрабіць гэтыя кампрамісы абавязковымі і патрабаваць ад платформаў надаваць пэўным каштоўнасцям асаблівую вагу. Напрыклад, калі б мы лічылі, што любое выкарыстанне ў адукацыйных мэтах абавязкова з’яўляецца добрасумленным, мы маглі б абавязаць платформы перанастроіць свае сістэмы так, каб яны ніколі не выдалялі кантэнт, які выкарыстоўваецца ў адукацыі. Але асноўны прынцып аспрэчвальных алгарытмаў — трымаць спаборніцкую сістэму асобна ад пануючай сістэмы мадэрацыі. Замест таго каб спрабаваць перанастроіць зыходную сістэму і змяніць яе мадэль аптымізацыі, я прапаную, каб «законнае выкарыстанне» вызначала незалежная сістэма.
Адна з прычын аддаць перавагу спаборніцкай мадэлі перад абавязковым правілам кампрамісу ў тым, што часта мы проста не ведаем, якія кампрамісы тут дарэчныя. Класічны прыклад — дактрына добрасумленнага выкарыстання ў амерыканскім аўтарскім праве (раздзел 107 Закона ЗША аб аўтарскім праве). Гэты адкрыты стандарт зыходзіць з таго, што ў дынамічным свеце, дзе тэхналагічныя і эканамічныя абставіны хутка мяняюцца, немагчыма прадбачыць усе выпадкі, калі абароненыя матэрыялы можна законна выкарыстоўваць без дазволу. Таму закон наўмысна не задае яўных кампрамісаў. Замест гэтага ён упаўнаважвае суды падладжваць абмежаванні капірайту, улічваючы чатыры фактары (мэту і характар выкарыстання; прыроду абароненага твора; аб’ём запазычанага; уплыў на рынак), калі яны вырашаюць, ці законнае несанкцыянаванае выкарыстанне таго ці іншага твора.
Іншая прычына не вызначаць кампрамісы жорстка і загадзя ў тым, што, нават калі дарэчныя кампрамісы ў тэорыі можна вызначыць, дасягнуць грамадскай згоды пра тое, як іх прымяняць, можа быць цяжка. Калі мы абавяжам платформы закладаць абавязковыя грамадскія кампрамісы, грамадству давядзецца вызначыць усе кампрамісы загадзя. Кіраванне праз правілы, наадварот, дазваляе грамадскім актарам дамовіцца пра агульныя прынцыпы (напрыклад, што аўтарскае права абмяжоўваецца добрасумленным выкарыстаннем), а дэталі кампрамісаў пакінуць судам, якія потым будуць прымяняць гэтыя прынцыпы ў канкрэтных справах. Так прававая сістэма пакідае месца для нязгоды. Плюралістычнае кіраванне якраз і зыходзіць з таго, што грамадзяне не заўсёды згодныя між сабой, як ураўнаважваць канкуруючыя каштоўнасці і інтарэсы. Таму наш дэмакратычны лад пакідае месца для нязгоды, ствараючы інстытуты, дзе кампрамісы можна абмяркоўваць, узгадняць і вырашаць (выбары) і дзе яны падлягаюць нагляду (судовы кантроль).
Каб захаваць плюралізм, спаборніцкая стратэгія абірае працэдурны падыход. Яна не задае ніякай канкрэтнай нормы, а стварае працэдуру, каб у алгарытмічным асяроддзі можна было аспрэчваць канкуруючыя каштоўнасці. Гэта дэмакратычны крок: нам не трэба дасягаць згоды пра кампрамісы — дастаткова дамовіцца пра легітымную працэдуру, паводле якой яны будуць вырашацца. Такі падыход можа абысці і канстытуцыйныя перашкоды. У некаторых краінах, напрыклад у ЗША, навязванне платформам пэўных кампрамісаў законам можа лічыцца радыкальным умяшаннем у свабоду слова — і таму неканстытуцыйным.
Больш за тое, спаборніцкая мадэль можа выразней правесці мяжу паміж публічным і прыватным, дапамагчы аспрэчваць легітымнасць прыватных рашэнняў аб выдаленні і звузіць маштаб выдалення кантэнту. Пры маналітным уладкаванні цяжка дакладна ўбачыць, які палітычны выбар фактычна зрабіла цяперашняя сістэма: напрыклад, якія прыкметы ўлічваліся, калі вызначалася дапушчальнае выказванне, і якую вагу мела кожная. Спаборніцкая мадэль павінна выразна раздзяліць два аўтаматызаваныя працэсы, што вызначаюць каштоўнасці, — прыватны і публічны. Кожная сістэма будзе аптымізаваць тыя мэты, дзеля якіх яна створаная. А калі кампрамісы становяцца яўнымі, іх можна абмяркоўваць і выносіць пад грамадскі кантроль.
Дынамічны пастаянны нагляд
Мадэрацыя кантэнту з дапамогай ШІ не грунтуецца на правілах. Як ужо было сказана, мадэрацыя на машынным навучанні ўключае пятлю зваротнай сувязі, у якой мадэль удасканальваецца з улікам сваёй мінулай працы. Даныя і ёсць код. Такі дынамічны спосаб прымяняць і ствараць нормы можа быць несумяшчальны з загадзя вызначаным абавязковым кампрамісам. Уявім, напрыклад, абавязковы кампраміс, які аддае перавагу адукацыйнай мэце перад абмежаваннямі капірайту: колькаснае азначэнне адукацыйнага выкарыстання з часам можа мяняцца, адлюстроўваючы тое, чаму сістэма навучылася на новых даных. Калі мы не давяраем платформам вырашаць такія рэчы, нам патрэбная стратэгія, якая дазволіць аспрэчваць гэтыя вынікі дынамічна.
З прычын, разгледжаных вышэй, мы не можам разлічваць, што платформы пераадолеюць свой канфлікт інтарэсаў, калі будуць навучаць і змяняць алгарытмы. Да таго ж кантроль за выкананнем грувасткіх правілаў — такіх, як правілы мадэрацыі кантэнту, — хутчэй за ўсё, будзе дарагім і неэфектыўным. Прапанаваная спаборніцкая сістэма можа пераадолець частку гэтых цяжкасцей, увёўшы дынамічную стратэгію пастаянных праверак.
Вяртанне грамадскага інтарэсу
Пануючая сістэма выдалення ўвасабляе каштоўнасны выбар, прадыктаваны камерцыйнымі інтарэсамі платформаў і іх бізнес-партнёраў. Гэты выбар яшчэ больш умацоўваюць механізмы навучання, на якіх сістэма грунтуецца. Калі альтэрнатыўных каштоўнасцей і кампрамісаў няма, сістэма становіцца маналітнай. Паколькі мы не можам давяраць платформам улічваць патрэбныя грамадскія кампрамісы, мы павінны дамагчыся, каб існавала актуальная альтэрнатыўная фармулёўка тых каштоўнасцей, якіх няма ў пануючай платформе.
Калі сфармуляваць каштоўнасці і інтарэсы зацікаўленых бакоў, недастаткова прадстаўленых у пануючай сістэме выдалення на аснове ШІ, з’явіцца прастора, каб распрацаваць паўнавартасную публічную альтэрнатыву гэтай сістэме. Тут алгарытмічнае кіраванне адкрывае новыя магчымасці: і зборка асобных мадэляў, і дзеянні розных зацікаўленых бакоў, якія з яе вынікаюць, запісаныя ў лічбавым кодзе.
Канкурэнцыя і інавацыі
Калі заахвоціць платформы праганяць свае даныя пра выдаленні праз Грамадскі ШІ, гэта не толькі дазволіць трымаць грамадства «ў контуры», але і можа даць даныя, неабходныя для інавацый.
Платформы часта не дзеляцца сваімі данымі адкрыта. Абгароджваючы гэтыя даныя, платформы не толькі ўскладняюць кантроль над сваімі кіраўнічымі функцыямі, але і ствараюць перашкоды для распрацоўкі сістэм ШІ ў грамадскіх інтарэсах. Каб эфектыўна выяўляць законнае выкарыстанне, аспрэчвальным алгарытмам патрэбныя даныя пра выдаленне незаконнага кантэнту. Калі абавязаць платформы правяраць нібыта незаконны кантэнт праз аспрэчвальную сістэму, з’явяцца незаменныя даныя, каб распрацоўваць і ўдасканальваць такія сістэмы. А гэта, у сваю чаргу, можа спрыяць з’яўленню рынку незалежных сістэм, якія выяўляюць законнае выкарыстанне і ў іншых кантэкстах. Напрыклад, сістэмы ШІ, што распазнаюць добрасумленнае выкарыстанне, могуць спатрэбіцца навучальным установам, якія даюць доступ да вялікіх аб’ёмаў навучальных матэрыялаў і павінны ўвесь час вызначаць, што з’яўляецца добрасумленным выкарыстаннем. Канкурэнтны рынак ШІ для выяўлення законнага выкарыстання будзе спрыяць інавацыям: канкурэнцыя будзе прымушаць гульцоў рынку ўкладаць у паляпшэнне сваіх сістэм.
Высновы
Мадэль аспрэчвальных алгарытмаў імкнецца ўтаймаваць уладу прыватных платформаў прымушаць выказванні змоўкнуць — вярнуўшы грамадскі інтарэс у контур машыннага навучання. Яна можа стаць практычным інструментам, каб паменшыць колькасць ілжыва станоўчых спрацоўванняў пануючых сістэм выдалення. Ілжыва адмоўных — то бок рашэнняў пакінуць кантэнт, нягледзячы на яго магчымую шкоду грамадскаму інтарэсу, — яна не закранае. З прычын, разгледжаных у гэтым артыкуле, такія выпадкі ствараюць праблему іншага кшталту, з якой можна змагацца існымі прававымі і грамадскімі сродкамі нагляду.
Аспрэчвальныя алгарытмы могуць мець і палітычнае вымярэнне. Мадэрацыю кантэнту з дапамогай ШІ можна разглядаць як магутную сістэму сацыяльнай інжынерыі, створаную, каб прасоўваць загадзя вызначаныя каштоўнасці. У мадэль сістэмы закладзены каштоўнасны выбар (напрыклад, што лічыць незаконным выказваннем), і гэты выбар умацоўваецца механізмамі навучання, на якіх сістэма грунтуецца. Калі альтэрнатыўных каштоўнасцей і кампрамісаў няма, гэтая магутная сістэма становіцца маналітнай і пагражае нашай дэмакратычнай дыскусіі.
Магчымасць спаборніцкага ўмяшання можа дазволіць членам грамадства фармуляваць грамадскія інтарэсы не проста як крытыку, а як дзейсны інструмент, падлучаны да пануючай інфраструктуры. Гэты новы від калектыўнага дзеяння можа павысіць падсправаздачнасць, адкрыўшы прастору для палітычнага дзеяння вакол таго, якімі павінны быць кампрамісы. Увогуле, такая мадэль можа пашырыць свабоду ў свеце, якім усё больш кіруе ШІ.
Niva Elkin-Koren, «Contesting algorithms: Restoring the public interest in content filtering by artificial intelligence», Big Data & Society, т. 7, № 2, 2020. Пераклад з англійскай паводле артыкула ў часопісе Big Data & Society; анатацыя, ключавыя словы, спіс літаратуры, бібліяграфічныя спасылкі і спасылкі на нарматыўныя акты прапушчаныя, адзіная зноска ўключаная ў тэкст, схема працэсу (мал. 1) прапушчаная — яе змест апісаны ў тэксце. Арыгінал распаўсюджваецца паводле ліцэнзіі Creative Commons Attribution 4.0 International (CC BY 4.0), пераклад — на тых жа ўмовах.